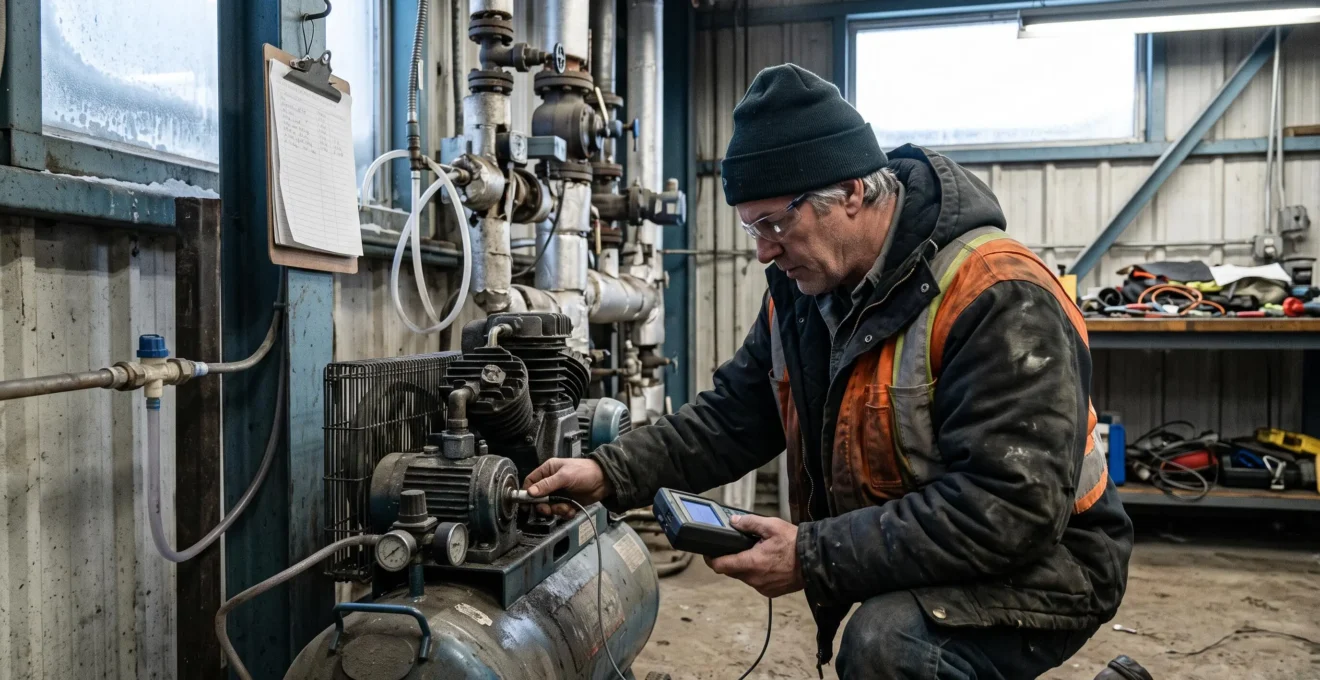
Un compresseur s’arrête en pleine production. Les capteurs indiquaient pourtant une pression normale et aucune alarme majeure. La maintenance intervient en urgence, la production attend et personne ne comprend pourquoi le système de surveillance n’a rien annoncé.
Dans une usine canadienne, particulièrement lorsque les équipements subissent de fortes variations de température, la réponse n’est pas nécessairement d’ajouter davantage de capteurs. Il faut d’abord vérifier si les défaillances importantes sont mesurables, si les données existantes permettent de reconnaître une dérive et si une équipe peut intervenir avant que cette dérive provoque un arrêt.
Une maintenance prédictive rentable commence par les modes de défaillance, pas par un catalogue de technologies. Un capteur supplémentaire n’apporte de valeur que s’il permet une décision utile : surveiller, confirmer une anomalie ou programmer une intervention au bon moment.
Cette démarche relie la fiabilité des machines, le coût réel des arrêts, les conditions climatiques canadiennes et les capacités des équipes sur le terrain. Elle permet de concentrer les investissements sur les équipements dont la surveillance peut réellement changer le résultat opérationnel.
Les décisions essentielles pour réduire les arrêts imprévus
- Analyser les dernières pannes avant d’acheter des capteurs : le problème peut venir de la mesure, de son interprétation ou de la réaction à une alerte.
- Prioriser les machines selon le coût réel de leurs arrêts, leur rôle dans la production et la possibilité de détecter leurs défaillances.
- Adapter les seuils aux conditions de fonctionnement et attribuer chaque niveau d’alerte à une action, un responsable et un délai.
- Pourquoi votre compresseur tombe en panne « sans signe » même avec des capteurs ?
- Comment définir des seuils d’alerte pour éviter les faux positifs à répétition ?
- Quelle machine instrumenter en premier quand une heure d’arrêt coûte 5 000 $ CAD ?
- L’erreur qui fait échouer un projet prédictif même avec de bons capteurs
- Quand intervenir après une alerte pour éviter de changer une pièce « trop tôt » ?
- Comment stabiliser un poste critique avec un contrôle en 5 points sur 2 quarts de travail ?
- Comment configurer 3 niveaux d’alertes pour éviter la majorité des notifications inutiles ?
- Tirer parti des plateformes sans devenir captif d’algorithmes ou de règles changeantes
Pourquoi votre compresseur tombe en panne « sans signe » même avec des capteurs ?
Un compresseur peut tomber en panne sans alerte parce que le signe précurseur n’a pas été mesuré, parce qu’une dérive présente dans les données n’a pas été reconnue ou parce qu’une alerte pertinente n’a déclenché aucune intervention. Avant d’ajouter des capteurs, il faut déterminer laquelle de ces trois situations explique les incidents précédents.
La première situation concerne le point de mesure. Un capteur installé sur le moteur peut suivre correctement sa température sans révéler une anomalie localisée dans un roulement, une vanne d’admission ou un équipement auxiliaire. De même, une pression de sortie nominale ne garantit pas le bon état de tous les composants du réseau d’air comprimé.
Les condensats constituent un exemple concret. Un purgeur défaillant peut laisser circuler de l’humidité vers les équipements en aval sans nécessairement provoquer une alarme sur la pression principale. Le référentiel technique de Ressources naturelles Canada sur l’air comprimé recommande notamment les contrôles périodiques des purgeurs, des filtres, des fuites et des paramètres de fonctionnement.
La deuxième situation survient lorsque la mesure existe, mais que son évolution n’est pas interprétée. Une augmentation graduelle des vibrations peut rester sous un seuil fixe pendant plusieurs semaines. La machine paraît alors normale alors que sa signature se dégrade.
La troisième situation est organisationnelle : l’alerte a été produite, mais personne n’a confirmé l’anomalie ou décidé d’une intervention.
Le climat canadien complique cette lecture. Les températures d’admission, la condensation et les régimes de fonctionnement peuvent varier fortement entre les saisons. Une référence construite uniquement en été risque de mal représenter certains comportements hivernaux. Cela ne signifie pas qu’un seuil est systématiquement invalide en hiver : il faut vérifier l’effet réel des conditions saisonnières sur chaque variable.
Pour identifier la cause dominante, reprendre les trois derniers arrêts non planifiés et examiner, pour chacun :
- Le composant réellement responsable de la panne.
- Les mesures disponibles avant l’arrêt et leur emplacement.
- L’existence éventuelle d’une dérive dans les données historiques.
- Les alertes émises, leur destinataire et les actions enregistrées.
Classer ensuite chaque incident dans la catégorie « non mesuré », « non interprété » ou « non traité ». Si la donnée était disponible, l’achat d’un nouveau capteur n’est probablement pas la première correction à apporter.
Une fois les points de mesure pertinents identifiés, le problème suivant consiste à reconnaître les dérives sans transformer chaque variation normale en fausse alarme.
Comment définir des seuils d’alerte pour éviter les faux positifs à répétition ?
Pour limiter les faux positifs, les seuils doivent tenir compte du régime de marche, des conditions saisonnières et de la variabilité réelle de chaque équipement. La méthode consiste à observer les données avant d’activer les alertes, puis à ajuster progressivement les règles de détection en comparant les déclenchements aux anomalies confirmées.
Un seuil unique paraît simple à gérer, mais peut devenir trompeur. Un compresseur chargé à pleine capacité n’a pas nécessairement la même signature thermique et vibratoire qu’un équipement en charge partielle. Comparer ces situations sans distinction peut produire une alarme inutile ou masquer une anomalie.
La calibration peut se dérouler en deux phases.
Phase 1 : établir les références de fonctionnement. Enregistrer les mesures sans générer de nouvelles notifications opérationnelles, tout en conservant les protections et alarmes de sécurité existantes. Documenter la charge, les températures ambiantes, les cycles de production et les états de marche. La période d’observation doit couvrir une diversité suffisante de conditions normales ; lorsqu’une saison n’est pas représentée, cette limite doit rester explicite.
Phase 2 : activer et examiner les alertes. Déployer d’abord les règles sur un équipement pilote, contrôler les déclenchements chaque semaine pendant la mise au point et distinguer les anomalies confirmées des événements sans action utile. Un seuil n’est pas satisfaisant simplement parce qu’il réduit le nombre de notifications.
Le manuel statistique du NIST sur les cartes de contrôle illustre le compromis entre sensibilité et fausses alarmes. Sous les hypothèses statistiques considérées, une carte de Shewhart utilisant uniquement une limite à trois écarts-types produit en moyenne une fausse alarme tous les 371 points. L’ajout de certaines règles de détection augmente la sensibilité, mais peut porter cette fréquence moyenne à une tous les 91,75 points.
371 contre 91,75 points
Nombre moyen de points entre fausses alarmes dans deux configurations statistiques présentées par le NIST, sous leurs hypothèses respectives. Ces valeurs ne représentent pas des fréquences observées sur les compresseurs canadiens.
NIST — documentation méthodologique sur les cartes de contrôle statistique.
Il n’existe donc pas de nombre universel de faux positifs acceptables par semaine. Le seuil de tolérance dépend du coût d’une inspection inutile, de la capacité des équipes à répondre et des conséquences d’une panne manquée.
| Situation | Coût à examiner | Décision de calibration |
|---|---|---|
| Alerte inutile fréquente | Temps d’inspection, interruption de travail, fatigue des équipes | Vérifier le contexte de mesure et la confirmation des tendances |
| Dérive détectée trop tard | Arrêt, dommages secondaires, réparation urgente | Réexaminer la sensibilité et la fréquence d’acquisition |
| Machine à fort enjeu de sécurité | Conséquences humaines et matérielles | Préserver les protections obligatoires indépendamment de l’optimisation des alertes |
Il faut enfin éviter de relever les seuils après chaque déclenchement jugé agaçant. Toute modification devrait être datée, justifiée par des données et validée par un responsable identifié. Les limites statistiques de surveillance ne remplacent jamais les limites de protection imposées par la conception, le fabricant ou les procédures de sécurité.
Des alertes fiables ont surtout de la valeur lorsqu’elles surveillent les équipements où une intervention préventive peut éviter une perte de production significative.
Quelle machine instrumenter en premier quand une heure d’arrêt coûte 5 000 $ CAD ?
La première machine à instrumenter n’est pas nécessairement la plus chère ni celle qui tombe le plus souvent en panne. Il faut privilégier un équipement dont les arrêts entraînent une perte importante, dont les défaillances présentent des signes mesurables et pour lequel une intervention anticipée est réalisable. Le coût de 5 000 $ CAD par heure doit d’abord être confirmé.
La priorité dépend de trois critères : l’historique réel des arrêts, la place de la machine dans le flux de production et la faisabilité de sa surveillance. Un équipement ancien qui tombe souvent en panne peut être moins prioritaire qu’un goulot d’étranglement plus fiable, mais dont chaque interruption immobilise une ligne entière.
À l’inverse, une machine critique disposant d’une redondance fonctionnelle peut supporter une défaillance sans arrêt immédiat de la production. Sa priorité dépendra alors du coût de réparation, du risque de panne simultanée et de la capacité de secours disponible.
Avant de classer les actifs, établir le coût horaire d’arrêt à partir des pertes effectivement attribuables à l’incident : production non récupérable, heures supplémentaires nécessaires, pertes de qualité, rebuts, frais logistiques et pénalités applicables. Il faut éviter d’additionner plusieurs fois une même perte ou de compter comme perdu un volume entièrement récupéré sans surcoût.
Le mode de défaillance compte autant que le coût. Un roulement présentant une dégradation progressive identifiable par analyse vibratoire peut constituer une cible pertinente. Une défaillance électronique brutale, sans précurseur mesurable avec les moyens disponibles, risque de produire un faible bénéfice prédictif malgré sa gravité.
Un livre blanc sur le choix des équipements à surveiller publié sur le site du NIST recommande d’évaluer les possibilités d’amélioration opérationnelle, les enjeux de sécurité, les coûts et bénéfices, ainsi que l’efficacité des mesures mises en œuvre. Il ne fournit toutefois aucun retour sur investissement garanti pour une installation particulière.
| Critère | Priorité plus élevée | Priorité plus faible |
|---|---|---|
| Historique des arrêts | Pertes récurrentes ou conséquences majeures | Incidents rares et conséquences limitées |
| Rôle dans la production | Goulot sans solution de secours | Équipement redondant avec reprise maîtrisée |
| Détectabilité | Dégradation progressive et mesurable | Défaillance soudaine sans indicateur exploitable |
| Action possible | Inspection et réparation réalisables avant l’arrêt | Aucun délai utile entre détection et défaillance |
Scénario pédagogique : comparer deux machines
Hypothèse : une usine estime à 5 000 $ CAD le coût d’une heure d’arrêt sur son poste limitant. La machine A cumule 10 heures d’arrêts non planifiés sur la période étudiée, soit une exposition historique de 50 000 $ CAD selon cette hypothèse. La machine B cumule autant d’heures, mais une redondance permet de maintenir la production.
La machine A peut être prioritaire si son mode de défaillance est détectable et si la surveillance permet réellement de planifier une intervention. Les 50 000 $ CAD ne constituent ni une économie réalisable garantie ni un résultat observé : il faut encore estimer la part des arrêts évitables et déduire les coûts de surveillance.
Le pilote devrait porter sur une seule machine au départ, avec des critères définis avant l’installation : anomalies pertinentes détectées, inspections confirmées, interventions planifiées, disponibilité et coûts complets. Une situation de référence documentée permettra de comparer les résultats sans attribuer automatiquement toute amélioration aux nouveaux capteurs.
Une machine bien choisie ne suffit toutefois pas. Sans organisation capable de convertir les données en décisions, même un pilote techniquement réussi peut devenir un tableau de bord sans effet sur les arrêts.
L’erreur qui fait échouer un projet prédictif même avec de bons capteurs
L’erreur centrale consiste à traiter la maintenance prédictive comme une installation technologique plutôt que comme un processus de maintenance. Un capteur peut mesurer correctement une anomalie sans éviter aucune panne. Pour produire un bénéfice, chaque alerte utile doit parvenir à une personne responsable, être évaluée et déboucher sur une décision traçable.
Le problème apparaît fréquemment à la frontière entre ingénierie, maintenance et production. L’équipe technique configure le système, le responsable de production protège son programme de fabrication et les mécaniciens doivent trouver une fenêtre d’intervention. Si personne ne possède explicitement la décision finale, une anomalie peut rester ouverte jusqu’à l’arrêt.
Le circuit doit préciser qui reçoit l’information, qui confirme le diagnostic, qui autorise l’intervention et comment le travail est enregistré dans le système de gestion de maintenance. Les délais doivent être proportionnés aux conséquences possibles : une anomalie lente ne suit pas la même procédure qu’un défaut susceptible de présenter un danger immédiat.
Un autre obstacle est l’absence d’historique exploitable. Les bons de travail peuvent indiquer « roulement remplacé » sans préciser les symptômes préalables, les conditions de charge ou le mécanisme de défaillance. Or, ces informations permettent de relier les mesures aux événements réels.
Le savoir des mécaniciens expérimentés est particulièrement précieux à ce stade. Un bruit inhabituel au démarrage, une odeur de surchauffe, une fuite intermittente ou un comportement différent à froid peuvent orienter la sélection des points de mesure. Ces observations doivent être confrontées aux données plutôt que transformées directement en règles automatiques non vérifiées.
Enfin, une proposition commerciale fondée sur un nombre de capteurs installés ne démontre pas que les défaillances dominantes sont surveillées. Pour chaque capteur, demander quel défaut il doit détecter, quel signal est attendu, comment l’alarme sera confirmée et quelle décision elle rend possible.
Checklist de lancement d’un pilote prédictif
- Identifier les trois principaux modes de défaillance de la machine pilote et produire une fiche reliant chaque mode à ses conséquences opérationnelles.
- Recenser les mesures existantes, leurs emplacements et leurs limites, puis établir un schéma des points de surveillance réellement nécessaires.
- Consulter les mécaniciens et les opérateurs des différents quarts et constituer un registre des symptômes observés avant les incidents.
- Attribuer les responsabilités de réception, diagnostic, décision et intervention dans une procédure d’escalade validée par la maintenance et la production.
- Définir les indicateurs de réussite, les coûts du pilote et les données de référence dans une fiche d’évaluation approuvée avant tout déploiement.
La checklist doit être vérifiée en conditions normales de production. Une alerte simulée peut notamment révéler qu’un destinataire est absent, qu’un accès au logiciel manque ou qu’aucune procédure ne prévoit de traiter l’événement pendant le quart de nuit.
Lorsque ce circuit fonctionne, une question plus délicate apparaît : à quel moment l’alerte justifie-t-elle réellement le remplacement d’une pièce ?
Quand intervenir après une alerte pour éviter de changer une pièce « trop tôt » ?
Une première alerte ne signifie pas nécessairement qu’une pièce doit être remplacée immédiatement. Elle indique généralement qu’une condition mérite une vérification, sauf si elle correspond à un seuil de protection ou à un danger identifié. Le moment d’intervention dépend ensuite de la vitesse de dégradation, du risque de panne et de la prochaine fenêtre de maintenance disponible.
Il faut distinguer détection d’anomalie et pronostic de défaillance. La première indique qu’une mesure ou un comportement s’écarte de sa référence. Le second cherche à estimer l’évolution future de l’état de la machine. Une hausse des vibrations ne permet pas, à elle seule, d’affirmer qu’un roulement cessera de fonctionner dans un délai précis.
Lorsqu’une anomalie non critique apparaît, la réponse consiste à confirmer la qualité de la mesure, examiner les autres indicateurs disponibles et augmenter la surveillance si nécessaire. Une inspection ciblée permet de rechercher des signes concordants : échauffement, changement acoustique, lubrification anormale ou évolution sous une charge comparable.
Une tendance confirmée doit ensuite être comparée aux possibilités réelles d’intervention. Si la dégradation paraît lente et que la prochaine fenêtre planifiée reste compatible avec le niveau de risque accepté, la surveillance peut se poursuivre. Si la vitesse de dégradation augmente ou que la fenêtre devient trop éloignée, il faut avancer l’inspection ou la réparation.
Le choix implique deux coûts opposés. Changer trop tôt gaspille une partie de la durée de vie utile du composant, ajoute des dépenses de main-d’œuvre et expose la machine aux risques liés au démontage et au remontage. Attendre trop longtemps peut provoquer des dommages secondaires, immobiliser des équipements en aval et rendre l’intervention beaucoup plus coûteuse.
Avant de fixer la date, le planificateur devrait examiner les pièces de rechange disponibles, les délais d’approvisionnement, le personnel qualifié, les exigences de consignation et les conséquences d’une défaillance pendant la production.
Dans une usine canadienne, les changements saisonniers doivent aussi entrer dans l’évaluation. Une anomalie observée en automne peut justifier une inspection avant l’hiver si le démarrage à froid ou les variations thermiques sollicitent davantage le composant concerné. Cette décision doit reposer sur le comportement connu de l’équipement, et non sur une hypothèse générale selon laquelle le froid accélère toutes les dégradations.
Les alertes critiques liées à la sécurité demeurent prioritaires : elles imposent l’application des procédures de protection et d’arrêt pertinentes, sans attendre la confirmation statistique d’une tendance.
Cette décision gagne en fiabilité lorsque les observations des opérateurs complètent les données automatisées, notamment pendant les démarrages et les changements de quart.
Comment stabiliser un poste critique avec un contrôle en 5 points sur 2 quarts de travail ?
Un poste critique peut être mieux surveillé en appliquant un contrôle court, identique sur les deux quarts de travail, centré sur ses cinq modes de défaillance les plus coûteux. Chaque point doit comporter un critère observable, une méthode sécuritaire et une consigne d’escalade. Les relevés doivent rejoindre le même historique que les données des capteurs.
Les inspections humaines apportent des observations que l’instrumentation existante ne couvre pas toujours. Un opérateur peut remarquer un bruit intermittent, une odeur inhabituelle, une fuite visible ou un comportement anormal au démarrage. Ces signes ne remplacent pas une mesure instrumentée, mais peuvent aider à détecter un défaut situé hors des points surveillés.
La principale difficulté est souvent la cohérence entre les équipes. Un bruit jugé normal par l’équipe de jour peut inquiéter celle de nuit. Sans référence commune, les transmissions deviennent subjectives et les dérives lentes peuvent traverser plusieurs relèves sans être reconnues.
Le standard devrait donc comporter des photographies de référence, des critères concrets et des consignes indiquant quand signaler une anomalie. Les vérifications doivent rester non intrusives, respecter les protections en place et exclure tout contact avec des pièces mobiles, sous tension ou présentant un risque thermique ou mécanique.
Les cinq points ne doivent pas être copiés d’une machine à l’autre. Ils découlent de l’analyse des défaillances locales. Pour un poste utilisant de l’air comprimé, ils pourraient par exemple concerner des fuites accessibles, des purgeurs, des indications de pression, des bruits anormaux et le comportement au démarrage, à condition que ces observations correspondent effectivement aux risques du poste.
Chaque contrôle doit produire une information comparable : état normal ou anormal, heure, équipe, observation éventuelle et personne avisée. Les mesures numériques doivent être accompagnées de leur unité et des conditions de fonctionnement. Une photographie peut compléter un relevé lorsqu’elle facilite la comparaison.
Les observations manuelles ont davantage de valeur lorsqu’elles sont rapprochées des mesures automatisées. Une hausse de vibration accompagnée d’un bruit inhabituel possède une signification opérationnelle différente d’une variation isolée sans anomalie corroborée. La décision reste néanmoins fondée sur l’évaluation du risque et les procédures applicables.
Pour préserver l’application sur les deux quarts, chronométrer le contrôle en production réelle. S’il devient trop long ou nécessite de franchir une zone dangereuse, il faut revoir son périmètre plutôt que demander aux opérateurs d’improviser. Un contrôle de trois points réellement effectués est préférable à un formulaire de sept points systématiquement ignoré.
Le superviseur devrait aussi examiner les écarts entre les deux quarts et traiter les observations non résolues avant qu’elles deviennent de simples mentions répétées dans le registre.
Une fois ces observations intégrées, le système peut hiérarchiser les événements plutôt que solliciter les équipes pour chaque variation détectée.
Comment configurer 3 niveaux d’alertes pour éviter la majorité des notifications inutiles ?
Une architecture efficace sépare les alertes selon l’action attendue : suivre une dérive, vérifier une anomalie ou agir sur un risque confirmé. Les événements de faible priorité restent consultables sans notification immédiate, tandis que les événements importants sont dirigés vers les responsables concernés. Cette organisation réduit le bruit sans présumer d’un pourcentage d’amélioration garanti.
Le classement doit commencer par les conséquences opérationnelles, et non par des appellations abstraites comme faible, moyen ou élevé. Deux anomalies de même amplitude peuvent nécessiter des actions différentes selon la machine, sa redondance et le contexte de production.
| Niveau | Action attendue | Routage recommandé |
|---|---|---|
| 1 — Suivre | Conserver la trace et observer la tendance sans intervention immédiate | Tableau de bord et historique consultable |
| 2 — Vérifier | Confirmer l’anomalie et planifier une inspection selon le risque | Responsable de maintenance et suivi dans la GMAO |
| 3 — Agir | Appliquer la procédure d’intervention ou de mise en sécurité prévue | Notification immédiate aux responsables désignés et escalade si nécessaire |
Cette architecture doit conserver une distinction entre les alertes prédictives et les alarmes de sécurité. Un dépassement exigeant une protection immédiate ne doit jamais être retardé par un filtrage visant à réduire les notifications.
Pour les anomalies non critiques, les déclenchements isolés peuvent être distingués des tendances persistantes. Une règle exigeant plusieurs mesures consécutives, ou une durée minimale de dépassement, peut éliminer une partie des événements transitoires. Elle peut aussi retarder la détection d’un défaut rapide : sa pertinence doit être évaluée selon le mode de défaillance.
Le routage mérite autant d’attention que le seuil. Un message de niveau 2 doit rejoindre une personne capable d’organiser la vérification pendant la plage concernée. Pour le niveau 3, le système doit permettre l’accusé de réception et prévoir une escalade lorsqu’aucun responsable ne prend en charge l’événement dans le délai fixé par la procédure locale.
L’objectif parfois évoqué de 80 % de notifications inutiles en moins n’est pas une performance démontrée par les sources disponibles. Il peut servir de cible interne uniquement après avoir mesuré la situation initiale et vérifié que la réduction du volume n’entraîne pas davantage de défauts manqués.
Un audit trimestriel devrait distinguer les notifications utiles, les fausses alertes, les doublons, les défauts de routage et les anomalies non détectées lorsqu’elles sont identifiables. Modifier une règle à la fois facilite l’évaluation de ses effets et évite de rendre le système moins sensible sans s’en apercevoir.
Un système d’alertes bien réglé doit toutefois rester compréhensible et maîtrisable par l’usine, même si son fournisseur modifie ses tarifs, ses algorithmes ou les conditions d’accès aux données.
À retenir avant de choisir une plateforme
- Une donnée de surveillance doit rester accessible à l’usine indépendamment du tableau de bord qui l’exploite.
- Les règles d’alerte doivent pouvoir être expliquées, révisées et adaptées aux modes de fonctionnement locaux.
- La continuité des procédures de maintenance doit être vérifiée même en cas d’indisponibilité ou de remplacement du fournisseur.
Tirer parti des plateformes sans devenir captif d’algorithmes ou de règles changeantes
Une plateforme de surveillance peut centraliser les données, faciliter les diagnostics et structurer les interventions. Elle devient problématique lorsque l’usine ne peut plus récupérer ses historiques, comprendre ses alertes ou maintenir son dispositif après un changement de fournisseur. La réversibilité technique et contractuelle doit donc être évaluée avant l’engagement.
La première forme de dépendance concerne les données. Une plateforme peut afficher plusieurs années de tendances sans proposer l’export exploitable des mesures brutes. Les résultats calculés sont parfois accessibles, mais pas les séries temporelles qui permettraient de reconstruire les analyses ailleurs.
Les données brutes doivent rester récupérables. Le contrat et les essais techniques devraient préciser les formats d’export, les unités, les horodatages, les identifiants des équipements, les métadonnées et les modalités de récupération des historiques en fin d’abonnement.
Une publication du NIST sur l’interopérabilité des capteurs industriels souligne l’importance des interfaces ouvertes, des formats normalisés et des standards de communication. Elle fournit des principes techniques utiles, sans garantir qu’un fournisseur particulier permettra de récupérer ses modèles prédictifs ou toutes ses configurations.
La deuxième dépendance touche les algorithmes. Si une plateforme signale un risque élevé sans expliquer les variables qui ont changé, l’équipe peut difficilement vérifier si le déclenchement reflète une véritable dégradation ou un comportement saisonnier normal. Il faut rechercher une explication suffisamment claire pour permettre un diagnostic humain et une configuration locale, tout en reconnaissant que certains modèles complexes ne sont pas entièrement transparents.
La troisième dépendance est organisationnelle. Lorsque toute la connaissance du système se limite à l’interface du fournisseur, une modification logicielle peut perturber les habitudes de maintenance. Les règles d’escalade, les historiques d’intervention et les responsabilités doivent donc exister dans des procédures maîtrisées par l’usine.
Avant de signer, le responsable du projet peut demander une démonstration pratique de réversibilité portant sur les points suivants :
- Export d’un échantillon de données brutes et vérification de sa lisibilité dans un outil indépendant.
- Documentation des capteurs, protocoles de communication et méthodes d’acquisition.
- Possibilité de consulter ou reproduire les règles d’alerte essentielles hors de l’interface propriétaire.
- Conditions de restitution des données, délais de résiliation, frais de sortie et évolution contractuelle des tarifs.
- Maintien des fonctions de protection, de surveillance et des procédures humaines en cas d’indisponibilité du service.
Un essai de sortie avant l’achat est particulièrement révélateur. Dans un environnement contrôlé, il s’agit de simuler une indisponibilité de la plateforme et de vérifier quelles mesures restent accessibles, quelles alertes cessent de fonctionner et comment les équipes poursuivent la gestion des anomalies.
Cette vérification ne doit jamais impliquer la désactivation d’une protection indispensable. Les fonctions critiques doivent être examinées selon les exigences de sécurité applicables à l’installation.
La plateforme idéale n’est donc pas nécessairement celle qui fournit le plus de prédictions. C’est celle qui permet d’obtenir des décisions de maintenance fiables tout en conservant des données utilisables, des procédures documentées et une capacité réelle de changement.
La prochaine action consiste à auditer une machine critique, ses trois dernières pannes, ses points de mesure et son circuit d’alerte. Ce diagnostic permet de rédiger un cahier des charges limité aux besoins démontrés, puis de tester la valeur de la solution avant tout déploiement à l’échelle de l’usine.
Faut-il installer des capteurs supplémentaires pour commencer la maintenance prédictive ?
Non. Les mesures déjà disponibles dans les systèmes de commande, les historiques de maintenance et les inspections peuvent constituer un point de départ. Des capteurs supplémentaires deviennent pertinents lorsqu’un mode de défaillance important n’est pas suffisamment observable et que sa détection permet une intervention utile.
Comment savoir si une panne était réellement impossible à anticiper ?
Il faut analyser le mécanisme de défaillance et rechercher d’éventuels signes antérieurs dans les mesures, les événements système et les observations des équipes. L’absence d’alerte ne prouve pas l’absence de précurseur. Certaines défaillances restent néanmoins trop rapides ou insuffisamment mesurables pour permettre une anticipation opérationnellement utile.
Combien de données historiques faut-il pour calibrer des seuils fiables ?
Aucune durée universelle n’est établie par les sources présentées. Le volume nécessaire dépend du cycle de production, de la variabilité des mesures et des régimes de fonctionnement. Pour les équipements sensibles aux conditions climatiques, une référence ne couvrant qu’une seule saison doit être utilisée avec prudence jusqu’à ce que d’autres conditions aient été observées.
La maintenance prédictive doit-elle remplacer la maintenance préventive ?
Non. Les deux approches peuvent se compléter. La surveillance prédictive aide à programmer certaines interventions en fonction de l’état réel des équipements, tandis que les inspections réglementaires, les vérifications de sécurité, les activités préventives nécessaires et les opérations prescrites restent applicables. Le choix dépend du risque et des caractéristiques de chaque défaillance.
Comment mesurer le retour sur investissement d’un pilote prédictif ?
Comparer les coûts complets de la solution aux bénéfices raisonnablement attribuables au pilote : arrêts évités ou raccourcis, réparations d’urgence réduites et interventions mieux planifiées. Inclure les capteurs, les licences, l’intégration, la formation et le temps d’analyse. Les économies doivent être évaluées par rapport à une situation initiale documentée, sans supposer que toute amélioration de disponibilité provient de la nouvelle technologie.